
你有没有试过让一个小模型Agent帮你查个天气,结果它先花5秒写了一篇《论用户意图与城市参数缺失的辩证关系》?
不是模型笨,是它被惯坏了——一有事就开写。ReAct、Think-Step、Chain-of-Thought……听着高大上,落地全是token堆出来的‘思考表演’。苹果和CMU那帮人扒开一看:小模型每轮生成300个字的推理,其实90%都在复述常识,真正起决策作用的,就最后一句里的一个动词或一个名词。
所以他们干了件特别‘土’但特别狠的事:不许写了,直接选。
把‘我需要搜索这个建筑的展览信息’这种自由发挥,压缩成6个选项里挑一条:‘实体已知但目标信息缺失,用实体名+目标属性去搜索’。模型不用造句,只用打分或输出一个编号——一次前向,一个token,20毫秒完事。原来要3秒的思考链,现在300毫秒搞定。快不是因为算得快,是因为根本不用算了。
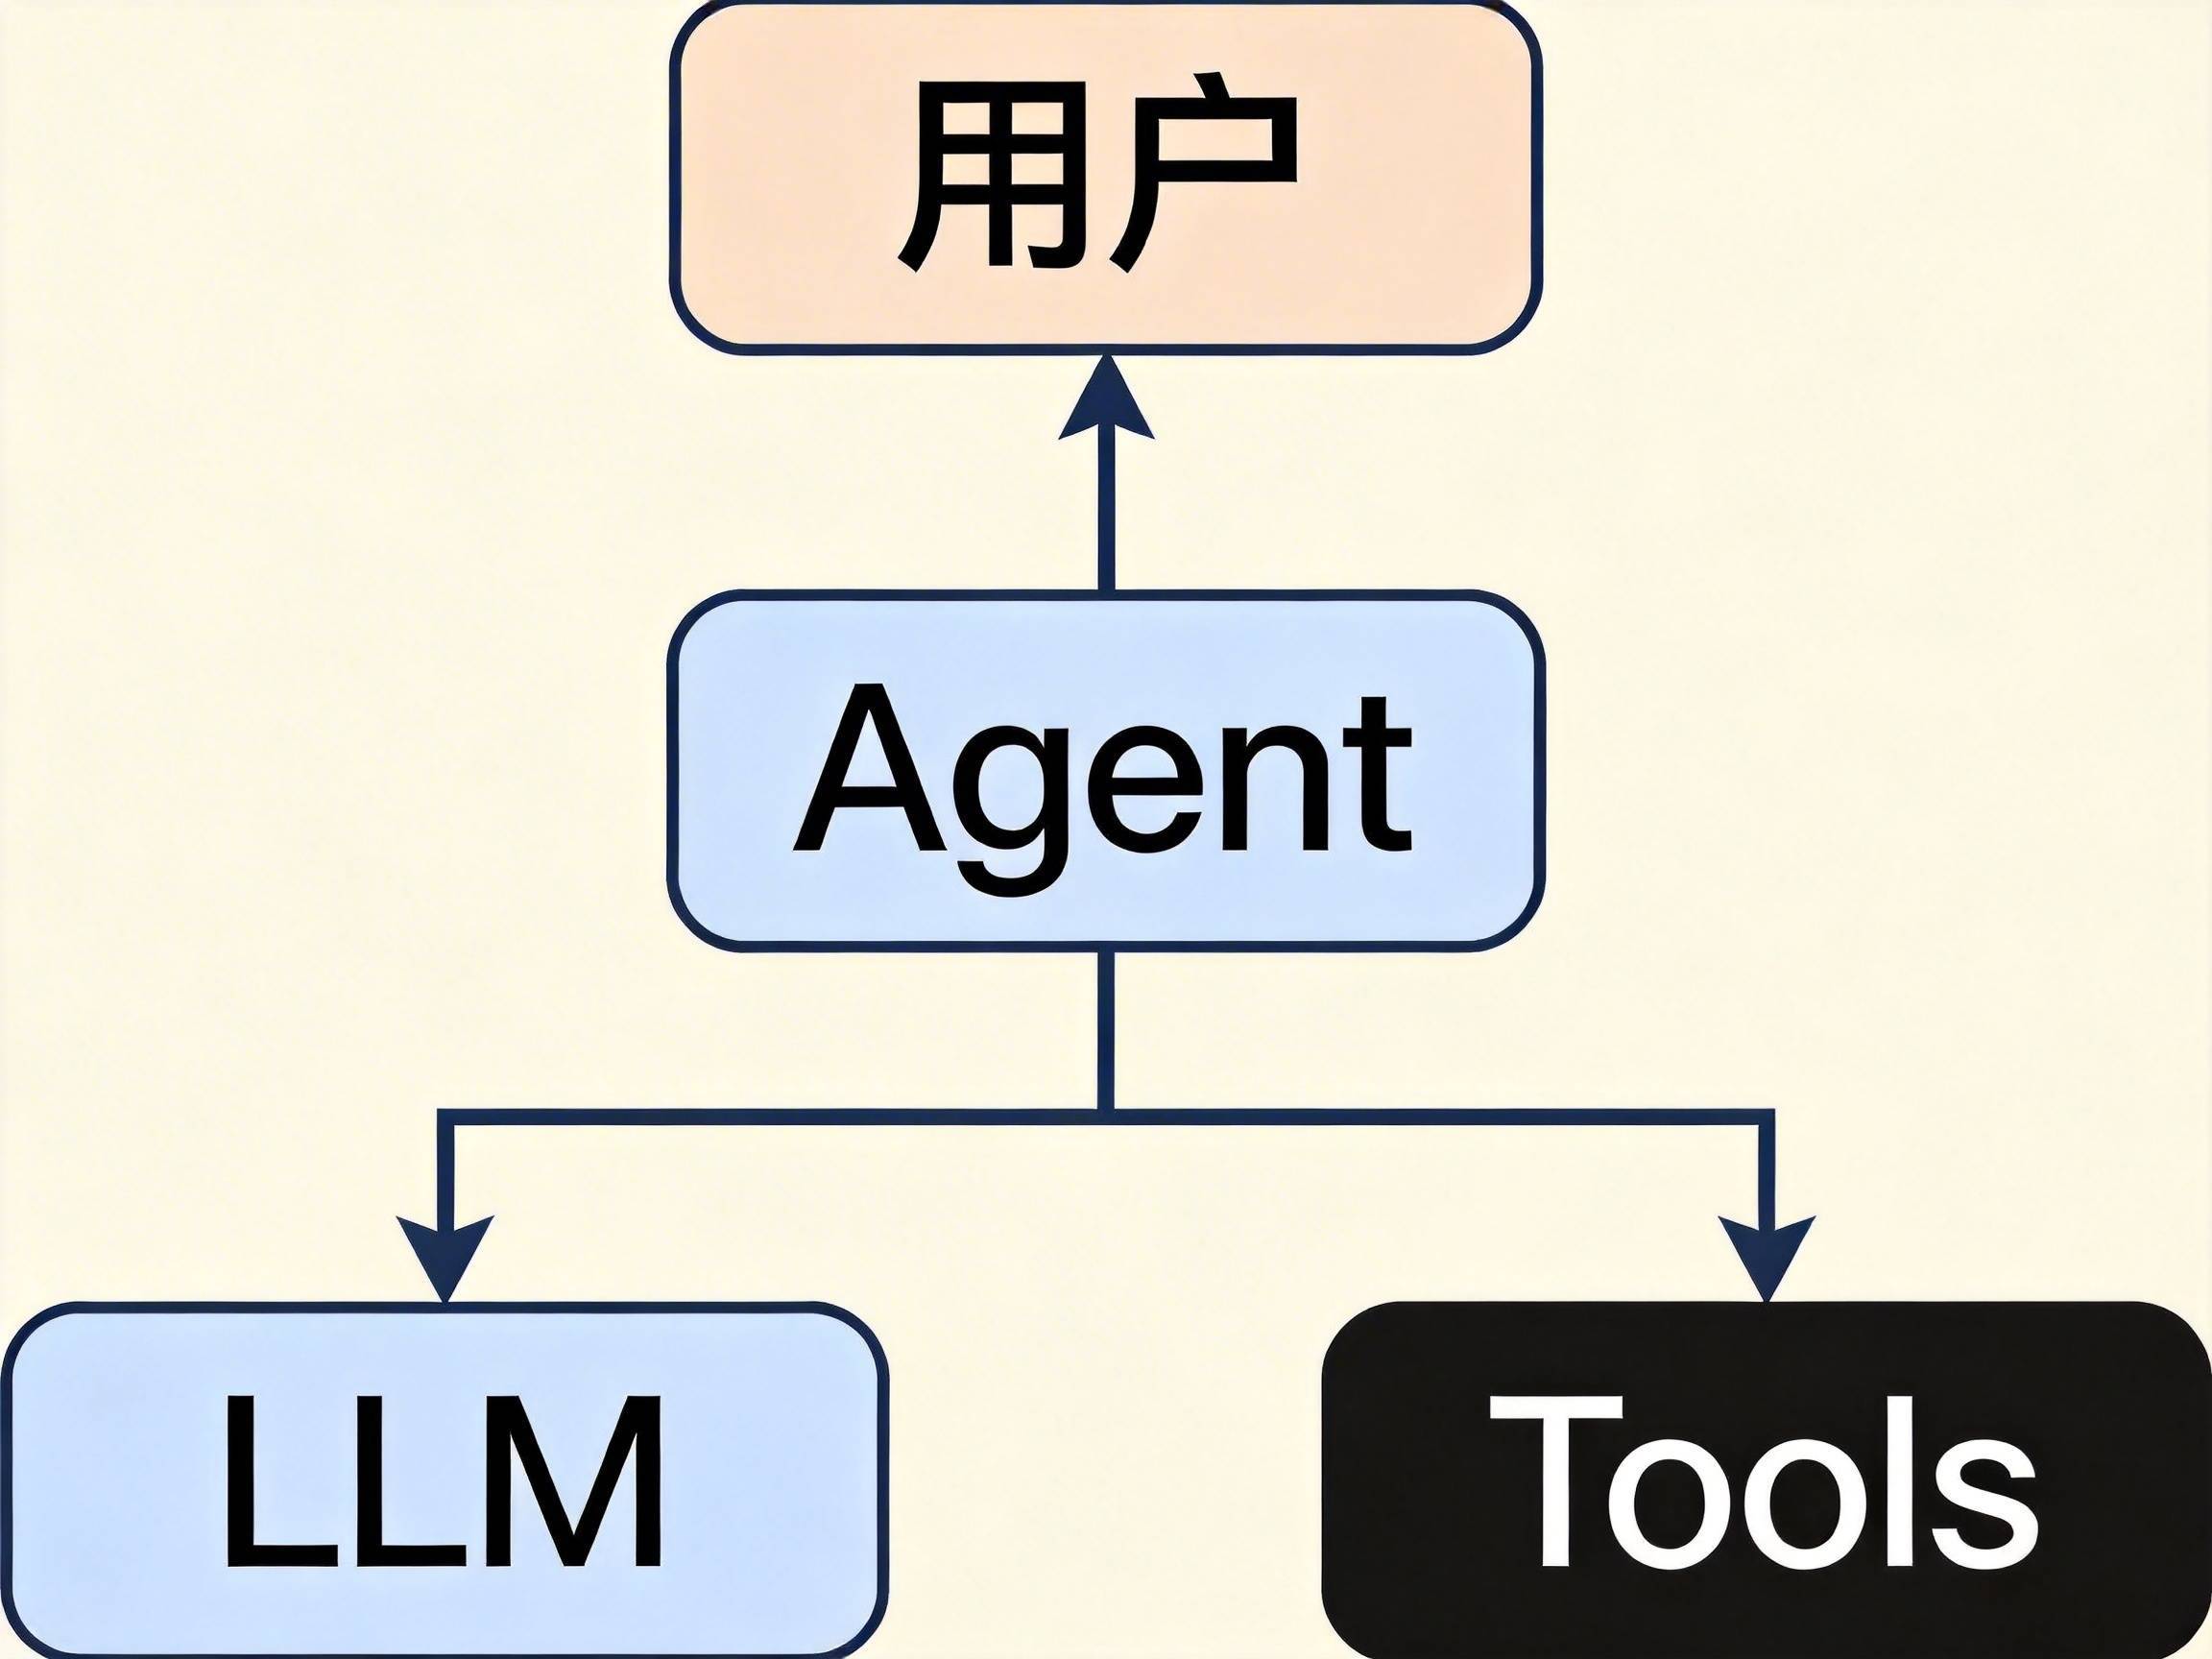
这招能成,靠的是一个朴素事实:大多数Agent任务根本不是开放创作,而是有限状态下的条件判断。查天气?就那几个动作:问城市、调API、报错重试、返回结果。订机票?无非是填时间、选航班、确认支付、失败兜底。这些‘思考’本质是分类题,硬塞给模型当作文题,纯属浪费显存、拖慢响应、还增加出错概率。
实测数据很打脸:7B模型在树莓派上跑多模态搜索,延迟从820ms压到85ms,吞吐翻6倍,准确率反而从91.3%升到94.2%。为啥?因为‘选’比‘编’更稳定——模型不会突然把‘搜展览’写成‘先问问馆长中午吃啥’。
这事儿听着像给AI“剪指甲”,其实是在帮它找回出厂设置。就像你家老人第一次用智能手机,不是教他写Python脚本,而是直接贴个“点这里打电话”的大按钮——简单、明确、不绕弯。小模型的算力和内存本来就不宽裕,硬逼它模仿人类边想边说,等于让自行车去跑F1赛道:姿势再帅,也赢不了。
更关键的是,这种“选而不写”的思路,意外撬动了模型对真实任务的理解深度。以前CoT训练靠人工写推理链,结果模型学的不是逻辑,是套路——看到“天气”就自动补“查XX市”,看到“机票”就接“出发时间+目的地”。可一旦换成选项打分,它必须真正区分:“用户说‘明天去上海’,是查航班?还是查高铁?还是查天气?”——分类边界变清晰了,幻觉自然少了一半。
有人担心:选项太少,覆盖不全?实测发现,6~12个精炼动作模板,能覆盖92%以上的日常Agent调用场景。不是靠堆数量,而是靠重设计——把“搜索”拆成“实体已知/未知”“属性明确/模糊”“API可用/不可用”三个维度交叉,组合出真正可执行的动作单元。连MIT去年的Agent评测报告都提到:在消费级设备上,动作分类准确率比生成式推理高17个百分点,且错误类型更集中、更容易修复。
最有趣的是,这波“减法革命”正在倒逼开发者换脑子。以前调优盯着loss曲线,现在盯着“用户第几次点击才选对动作”;以前夸模型“文笔好”,现在夸它“手稳、不抖、不废话”。连Hugging Face社区里,新上传的轻量Agent模型,README第一行写的不再是“支持Chain-of-Thought”,而是“Action Space: 8 primitives, zero-shot transferable”。
说白了,AI不需要当哲学家,它只需要当个靠谱的办事员。你让它查天气,它就该秒回“上海今天25℃”,而不是先发一篇《论云层与人类情绪的隐喻关系》。快,不是目的;准,才是底线;而少写一个字10倍杠杆配资,可能就少一次翻车。
牛配资提示:文章来自网络,不代表本站观点。


